
① Mục Đích
Bài viết này hướng dẫn cách update dữ liệu cho 1 table trong lakehouse bằng pyspark chạy trên notebook của Microsoft fabric
② Nội Dung
2-1. Hai loại update dữ liệu chính
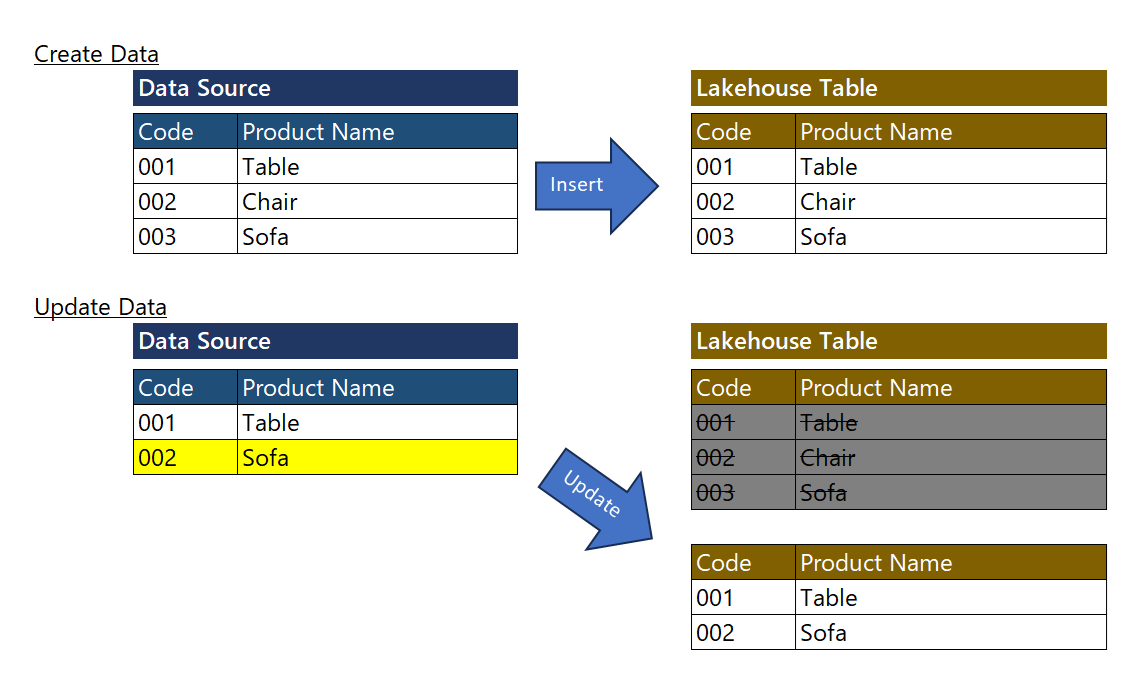
<Loại 1> Update toàn bộ dữ liệu
Đây là hình thức update toàn bộ dữ liệu trong table của lakehouse. Hình thức update này sẽ xóa bỏ tất cả dữ liệu hiện tại của table, và ghi toàn bộ dữ liệu mới vào table. Chúng ta có thể hình dung đây là phương pháp truncate – insert trong SQL server hay các hệ quản trị dữ liệu khác.
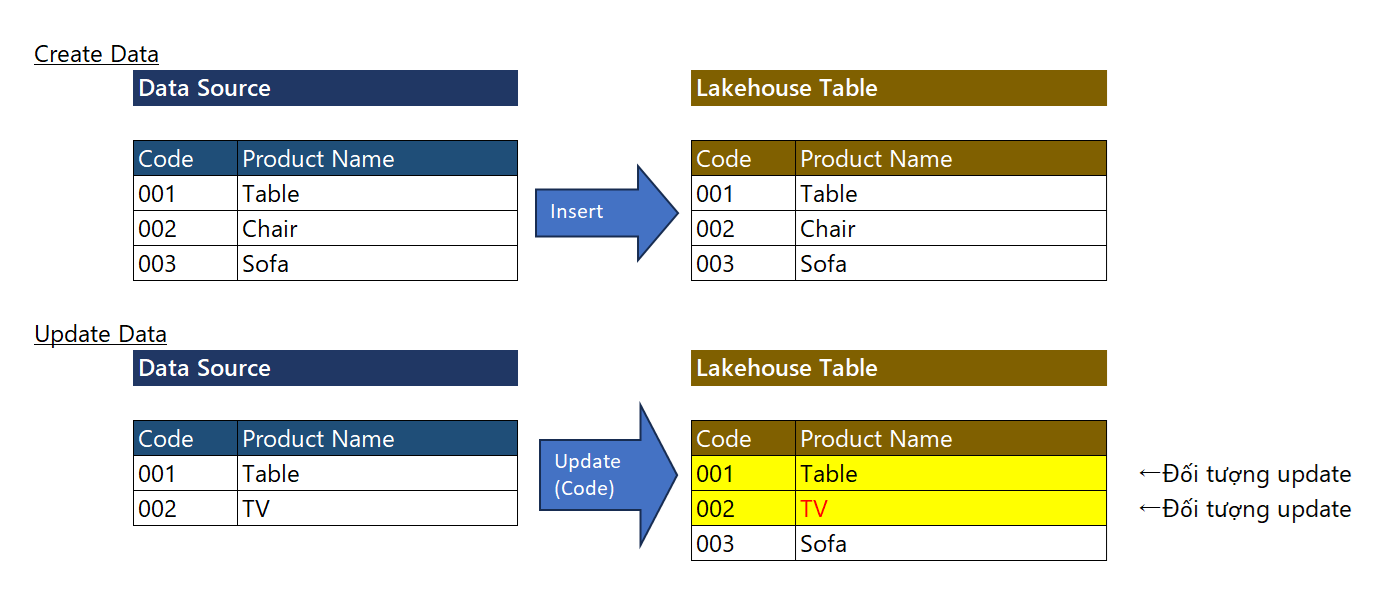
<Loại 2> Update 1 phần dữ liệu
Đây là hình thức update 1 phần dữ liệu trong table của lakehouse. Hình thức update này sẽ chỉ update những dòng dữ liệu được chỉ định (bằng điều kiện update)
2-2. Cách Thực Hiện
<Loại 1> Update toàn bộ dữ liệu
Với loại update toàn bộ dữ liệu. Chúng ta có thể dùng “overwrite” mode của pyspark để thực hiện việc update dữ liệu cho table.
# với spark_df_standard_sink là 1 spark data frame chứa nhưng dữ liệu dùng update cho table.

spark_df_standard_sink.write.format("delta").mode("overwrite").save(f"{nb_var_enrich_standard_table_fullpath}")
<Loại 2> Update 1 phần dữ liệu
Với loại update 1 phần dữ liệu. Chúng ta có 2 cách thường dùng để update dữ liệu
Cách 1: Dùng primary key của table để thực hiện update dữ liệu. Với cách này chúng ta có thể dùng phương thức merge để tiến hành như sau
# Định nghĩa table cần được update dữ liệu
delta_table = DeltaTable.forPath(spark,nb_var_enrich_standard_table_fullpath)

# Thực hiện merge. spark_df_standard_sink là 1 spark data frame chứa tất cả dữ liệu dùng để update cho table
delta_table.alias("target")\
 .merge(
  spark_df_standard_sink.alias("source"),
  "target.`DepartmentID` = source.`DepartmentID`" # Định nghĩa điều kiện update
 )\
# Nếu dữ liệu của spark_df_standard_sink thỏa điều kiện update trên thì sẽ tiến hành update tất cả những dữ liệu đó vào delta_table (bảng đích)
.whenMatchedUpdateAll()\
# Nếu dữ liệu của spark_df_standard_sink không thỏa điều kiện update trên thì sẽ insert những dữ liệu đó vào cho delta_table (bảng đích)
.whenNotMatchedInsertAll()\
.execute()  # thực hiện lệnh update
Giải Thích: Đoạn code trên sẽ thực hiện các bước xử lý sau
1. So sách giá trị của DeparmentID của spark_df_standard_sink và delta_table
2. Định nghĩa giá trị update cho các row dữ liệu thỏa điều kiện so sánh DepartmentID
3. Định nghĩa giá trị insert cho các row dữ liệu trong spark_df_standard_sink không DepartmentID trong bảng đích delta_table
4. Thực hiện việc update và insert dữ liệu (execute)
Cách 2: Dùng 1 hay nhiều column key để thực hiện delete và insert dữ liệu vào table đích. Cách thực hiện như sau.
# Định nghĩa các column sẽ là key để thực hiện xóa dữ liệu.
primary_keys = ['SaleYear']

# Lấy DeltaTable
delta_table = DeltaTable.forPath(spark, nb_var_enrich_standard_table_fullpath)

# Định nghĩa source dataframe. Với spart_df_standard_sink là spark dataframe chứa dữ liệu cần update cho table
source_df = spark_df_standard_sink.alias("source")

# Tạo điều kiện xóa dựa trên khóa chính
condition = " AND ".join([f"target.`{key}` = source.`{key}`" for key in primary_keys])

# Bước 1: Xóa các bản ghi trong bảng đích (target) mà có khóa chính trùng với bảng nguồn (source)
delta_table.alias("target") \
 .merge(source_df, condition) \
 .whenMatchedDelete() \
 .execute()

# Bước 2: Chèn dữ liệu mới từ bảng nguồn (source)
spark_df_standard_sink.write.format("delta").mode("append").save(f"{nb_var_enrich_standard_table_fullpath}")
Giải Thích: Đoạn code trên sẽ thực hiện các bước xử lý sau
1. Tiến hành tạo điều kiện để so sánh dữ liệu
2. Dùng merge để so sánh và thực hiện xóa tất cả các dữ liệu tìm thấy trong table đích (delta_table)
3. Thực hiện insert tất cả các dữ liệu của source vào bảng đích bằng mode “append”
③ Tóm tắt
Trên đây mình đã giới thiệu 2 phương pháp dùng để update dữ liệu phổ biến khi làm việc với lakehouse table (delta table) bằng pyspark trên notebook của Microsoft Fabric.
Tùy vào yêu cầu, input (data source) và khối lượng dữ liệu xử lý, chúng ta có thể chọn lựa, thiết kế phương thức hợp lý để tiến hành việc update dữ liệu cho table.